LE PMI GESTISCONO IN MODO FRAMMENTATO RICHIESTA, CLASSIFICAZIONE, ASSEGNAZIONE, AGGIORNAMENTI E CHIUSURA INTERVENTI: INFORMAZIONI MANCANTI, ASSEGNAZIONI NON COERENTI, COMUNICAZIONI AL CLIENTE DISCONTINUE E MANCANZA DI TRACCIABILITÀ/SLA, CON CONSEGUENTI RITARDI, REWORK E CONTESTAZIONI IN CHIUSURA.
Richieste di intervento: come organizzarle senza perdere pezzi per strada
Dal primo messaggio alla chiusura del lavoro: un modo semplice per sapere sempre cosa succede, chi se ne occupa e cosa manca.
Il punto in cui il processo si rompe
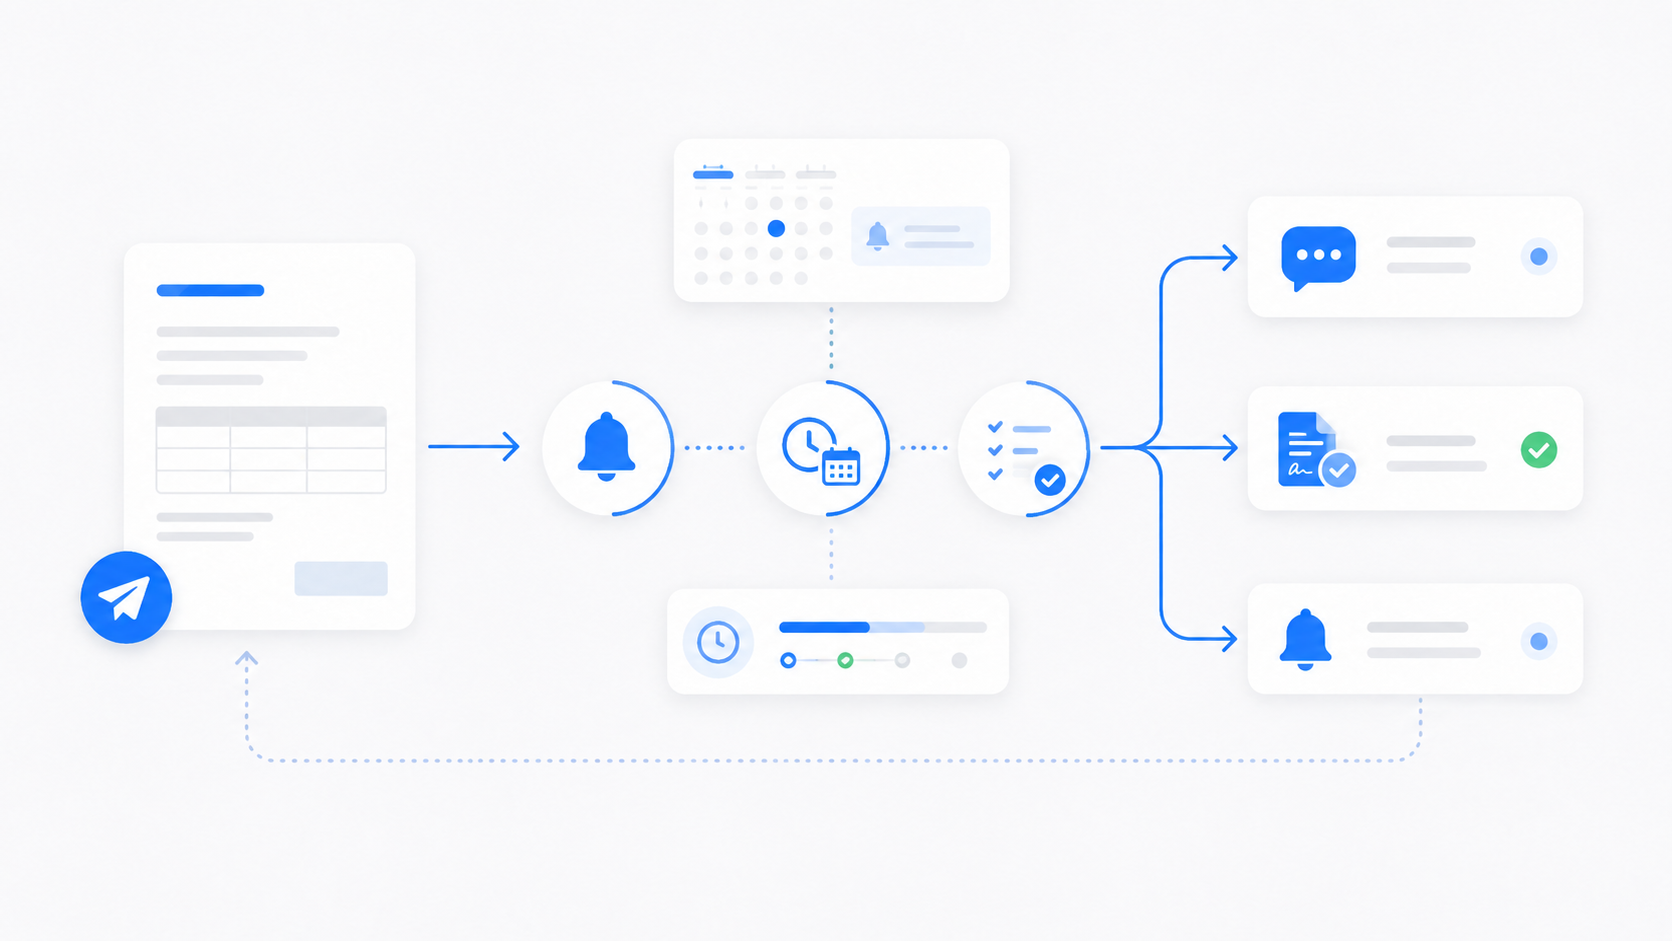
In molte PMI di impiantistica, manutenzione, servizi tecnici e noleggio il ciclo dell'intervento segue le stesse fasi: qualcuno segnala un problema, qualcuno lo valuta, qualcuno lo assegna, il tecnico lavora e aggiorna (quando se ne ricorda), infine l'intervento si chiude. Il problema non è l'assenza di un processo — un processo esiste sempre, anche se informale — ma la sua incoerenza: ogni operatore applica criteri diversi per capire cosa è urgente, chi deve intervenire, quando avvisare il cliente e cosa serve per dire che il lavoro è davvero finito.
Il risultato tipico è un mix di richieste incomplete che tornano indietro dopo un certo tempo, assegnazioni fatte per disponibilità del momento più che per competenza, clienti che chiamano per sapere "a che punto siamo" perché nessuno li ha aggiornati, e chiusure che vengono riaperte perché manca un documento o una firma. Nessuno di questi problemi richiede intelligenza artificiale per essere risolto: richiede regole scritte, stati definiti e un minimo di disciplina nei dati.
Questo articolo propone uno schema operativo in cinque fasi — richiesta, classificazione, assegnazione, aggiornamenti, chiusura — con esempi di regole utilizzabili da subito. Gli esempi sono segnalati come tali: non sono standard di settore, ma punti di partenza da adattare al proprio contesto.
Fase 1 — Standardizzare la richiesta con dati minimi obbligatori
La causa più comune di ritardo non è la mancanza di personale, ma l'incompletezza della richiesta iniziale. Se un ticket arriva senza indicazione dell'asset o della sede, qualcuno dovrà richiamare il cliente per capire di cosa si tratta, e quella telefonata spesso avviene più tardi rispetto all'apertura del ticket.
La soluzione pratica è definire un set di campi obbligatori sotto cui la richiesta non può passare alla fase successiva.
Esempio — dati minimi di una richiesta di intervento:
- cliente e sede;
- asset o impianto interessato;
- categoria della richiesta (guasto, manutenzione programmata, richiesta informativa);
- urgenza dichiarata dal richiedente;
- descrizione del problema;
- contratto, garanzia o SLA applicabile, se esistente;
- contatto reperibile per chiarimenti;
- eventuali allegati (foto, codici errore, documenti).
Regola utile: se manca l'asset o la sede, la richiesta resta in stato "incompleta" e non entra nel flusso di assegnazione. Questo vincolo, banale sulla carta, riduce i rimpalli successivi perché sposta il problema all'origine, non a metà processo.
Questo approccio è coerente con la logica dei sistemi di service management, dove la richiesta viene raccolta tramite moduli dedicati che raccolgono in anticipo le informazioni necessarie a instradarla correttamente, invece di lasciare che i dati arrivino a pezzi durante la lavorazione.
Fase 2 — Classificare senza lasciare la decisione al caso
Una volta che la richiesta è completa, va classificata secondo criteri espliciti: tipologia, urgenza, area/impianto coinvolto, contratto o cliente. La distinzione più utile, ripresa dalla letteratura ITSM, è quella tra incident (qualcosa che si è rotto e blocca un servizio) e service request (una richiesta pianificabile, come una manutenzione ordinaria o un'informazione). Le due categorie richiedono workflow e SLA diversi, perché un fermo impianto e una richiesta di manutenzione programmata non hanno la stessa urgenza né lo stesso percorso di gestione.
La priorità non dovrebbe essere una sensazione dell'operatore che risponde al telefono, ma il risultato di due variabili: impatto (quanto è grave la conseguenza) e urgenza (quanto è vicina nel tempo). Questo schema, adottato nelle matrici di priorità degli incident, riduce la variabilità tra chi classifica la stessa richiesta in modo diverso a seconda del giorno o dell'operatore di turno.
Esempio — regole di classificazione:
- se c'è fermo impianto o servizio bloccato → urgenza alta, categoria "incident";
- se la richiesta è pianificabile e non blocca nulla → categoria "service request";
- se il cliente ha un contratto con priorità dedicata → applicare la priorità contrattuale indipendentemente dalla valutazione dell'operatore;
- se mancano dati critici per classificare → stato "in triage", non assegnazione diretta al tecnico.
Questo schema è trasferibile a impiantistica e manutenzione, ma non è una norma universale: in ambienti di noleggio o servizi misti alcune richieste sono ibride (un guasto durante una manutenzione programmata, ad esempio) e servirà una policy interna per i casi ambigui, più che una regola valida in automatico per ogni situazione.
Fase 3 — Una matrice di assegnazione, non un'abitudine
L'assegnazione "a chi è libero in quel momento" è una causa frequente di interventi svolti da chi non ha la competenza giusta, con conseguente rework o secondo passaggio. Una matrice di assegnazione strutturata incrocia almeno quattro variabili:
Esempio — matrice di assegnazione:
- competenza tecnica: tipo di guasto, linea, marca, tipologia di asset;
- ubicazione: area geografica o sito di competenza;
- disponibilità: turno, reperibilità, agenda già pianificata;
- carico di lavoro: numero di ticket aperti o ore già assegnate.
Regola utile: assegnare automaticamente al primo tecnico che soddisfa tutti i filtri minimi; se nessuno risulta disponibile, aprire un'escalation di capacità invece di forzare l'assegnazione al primo nome libero. Questa logica di task workflow riduce i passaggi manuali superflui e rende l'assegnazione ripetibile, non dipendente dalla memoria di chi coordina.
È una struttura, non un algoritmo: il controllo umano resta necessario per i casi limite, ma la matrice riduce la parte di decisione arbitraria che oggi grava su chi smista le richieste.
Fase 4 — Stati tracciabili e aggiornamenti non lasciati al caso
Uno dei motivi per cui i clienti chiamano per chiedere aggiornamenti è che il passaggio di stato dell'intervento non genera nessuna comunicazione automatica. Definire uno schema di stati chiaro serve a due cose: sapere sempre dove si trova un intervento, e agganciare a ogni cambio di stato un'azione (notifica, promemoria, escalation).
Esempio — schema di stati intervento:
| Stato | Significato |
|---|---|
| Nuovo | Richiesta ricevuta, non ancora verificata |
| In triage | Verifica completezza dati e classificazione |
| In attesa informazioni | Bloccato per dati mancanti dal richiedente |
| Assegnato | Tecnico identificato, non ancora pianificato |
| Pianificato | Data e orario definiti |
| In corso | Intervento in esecuzione |
| In attesa terze parti/ricambi | Bloccato per fattori esterni |
| Risolto in verifica | Lavoro eseguito, verifica di conformità in corso |
| Chiuso | Checklist di chiusura completata |
Regola utile: ogni passaggio di stato genera un timestamp e un motivo testuale, anche breve. Senza questo minimo, non esiste tracciabilità reale: il ticket esiste, ma non racconta perché è cambiato stato né chi ha deciso cosa. Questo principio è coerente con i requisiti di identificazione e tracciabilità della ISO 9001, che richiede identificazione e tracciabilità quando applicabili.
Gli aggiornamenti al cliente vanno agganciati agli stessi trigger: un cambio di priorità alta comunica entro un tempo definito, un passaggio a "in attesa ricambi" genera una notifica automatica invece di lasciare il cliente senza notizie. La frequenza e il canale degli aggiornamenti dovrebbero variare in base alla priorità assegnata in fase 2, non essere uguali per ogni ticket.
Sullo stesso principio si costruiscono i promemoria SLA: se un intervento ad alta priorità non cambia stato entro un tempo definito, deve scattare un'escalation automatica verso il responsabile, non un controllo manuale a campione fatto quando qualcuno se ne ricorda.
Fase 5 — Chiudere con una checklist, non con una sensazione
La chiusura è il momento in cui si concentrano la maggior parte delle contestazioni: il cliente non riconosce il lavoro, manca un documento, non c'è conferma di chi ha autorizzato la chiusura. Una checklist obbligatoria prima della chiusura riduce questo rischio in modo diretto.
Esempio — checklist di chiusura:
- intervento eseguito e documentato;
- esito tecnico verificato;
- parti o ricambi utilizzati registrati;
- foto, rapportino o verbale allegati;
- firma o conferma del cliente, se prevista dal contratto;
- eventuali eccezioni o azioni residue registrate esplicitamente.
Regola utile: non consentire la chiusura se manca almeno uno dei campi obbligatori di consuntivazione. Questo vincolo tecnico, più che una policy scritta su carta, è quello che realmente impedisce le chiusure premature — la stessa logica di conferma è coerente con i modelli di incident/request management descritti nelle fonti ITSM, dove la chiusura richiede una verifica esplicita della risoluzione, non solo un cambio di stato.
Gestire le eccezioni senza perdere tracciabilità
Ogni processo standardizzato incontra casi che non rientrano nelle regole previste. La differenza tra un flusso robusto e uno fragile non è l'assenza di eccezioni, ma il modo in cui vengono trattate.
Esempio — gestione eccezioni:
- richiesta ambigua → stato "da chiarire" con domanda standard inviata al cliente;
- dato mancante → blocco soft con promemoria automatico dopo un tempo definito;
- caso fuori regola (es. priorità contestata, competenza non disponibile) → assegnazione a un supervisore che decide e motiva la deroga.
Regola utile: ogni deroga alle regole standard va registrata con autore, data e motivo. Senza questo passaggio, le eccezioni diventano la via preferenziale per bypassare il processo, e nel tempo il flusso "governato" smette di esistere nella pratica quotidiana.
Integrare con ERP/CRM senza rifare tutto
Molte PMI hanno già un ERP o un CRM in uso e temono che introdurre regole di classificazione o stati strutturati richieda di sostituire l'intero sistema informativo. Nella maggior parte dei casi non è necessario: il punto critico è mappare il flusso dei dati tra i sistemi esistenti e adottare un modello dati comune, con un dizionario di campi, valori ammessi e responsabilità chiare su chi aggiorna cosa.
Le pratiche di integrazione tra sistemi di field service, ERP e CRM raccomandano di documentare esplicitamente flussi, punti di scambio dati (API o interfacce esistenti) e governance delle modifiche, prima di automatizzare qualsiasi passaggio. In pratica significa partire da una domanda semplice: quali campi della richiesta di intervento devono esistere anche nel CRM (per la storia cliente) e quali nell'ERP (per fatturazione, magazzino ricambi, contratti)? Definita questa mappa, l'automazione dei passaggi diventa un'estensione del sistema esistente, non un progetto parallelo da gestire a sé.
Cosa non aspettarsi da questo schema
Questo modello a cinque fasi è trasferibile a impiantistica, manutenzione, servizi tecnici e noleggio, ma non è uno standard universale: non esiste una norma che imponga esattamente questi stati o questa matrice di assegnazione per ogni settore. I tempi SLA riportati nelle fonti ITSM variano molto in base a criticità e tipo di contratto, e non vanno adottati come benchmark senza adattarli al proprio servizio reale. Allo stesso modo, la distinzione tra incident e service request è utile come schema operativo, ma in contesti di noleggio o manutenzione mista alcune richieste restano ibride: serve una policy interna esplicita per i casi che non rientrano perfettamente in una categoria.
Infine, l'integrazione con ERP e CRM non ha un'unica architettura valida per tutte le aziende: dipende dai sistemi già in uso, dalla qualità dei dati esistenti e da eventuali vincoli tecnici legacy. Il valore di questo schema non è la formula esatta, ma la disciplina che impone: dati minimi verificati, classificazione con criteri scritti, assegnazione con regole esplicite, stati tracciabili e chiusura verificata.
Da dove partire concretamente
Prima di introdurre automazioni, ha senso mappare dove il processo attuale si rompe realmente: quante richieste arrivano incomplete, quante assegnazioni vengono corrette a mano dopo l'apertura, quanti clienti chiamano per chiedere aggiornamenti, quante chiusure vengono riaperte per documenti mancanti. Questi quattro punti, misurati anche in modo grezzo per due o tre settimane, indicano dove intervenire prima e con quale priorità.
CONTINUA A LEGGERE
Guide collegate
Richieste di intervento tra telefono, WhatsApp ed email? Come evitare il caos
Telefono, WhatsApp, email e foto sparse: quando una richiesta tecnica nasce male, il caos continua fino alla chiusura del lavoro. Ecco come rimettere ordine.
Leggi la guida
Ti fanno sempre le stesse domande? Come organizzare l’assistenza clienti
Orari, fatture, ordini, appuntamenti: molte richieste clienti si ripetono. Organizzarle bene permette di rispondere più velocemente senza automatizzare i casi delicati.
Leggi la guida
Troppe email da gestire? Cosa puoi automatizzare senza perdere il controllo
Leggere, inoltrare, cercare allegati, ricordarsi di rispondere: la gestione delle email può mangiare ore senza che ce ne accorgiamo. Ecco cosa conviene semplificare per primo.
Leggi la guidaFONTI VERIFICATE